

一開始,我對 AI Coding 的期待很單純。
把需求告訴 AI。
讓它幫我寫 Code。
有錯誤,再把錯誤訊息貼回去。
如果結果不對,就把 Prompt 改得更精確一點。
大概就是:
需求
↓
Prompt
↓
AI 寫 Code
↓
測試
↓
修改 Prompt
↓
再來一次
這個階段,「Prompt Engineering」確實很重要。
需求有沒有說清楚、限制有沒有列完整、輸出格式有沒有指定,往往直接影響結果。
但當 Codex 開始參與日常開發後,我慢慢發現一件事:
問題已經不只是 Prompt 寫得好不好。
我目前有幾個實際開發中的專案。
其中一個是公司內部使用的便當訂購系統。
它一開始只是很普通的內部工具,後來一路經過:
舊公司網頁
↓
GAS + Google Sheets
↓
React
↓
Cloudflare Workers
↓
D1
↓
LINE 登入
↓
員工編號綁定
↓
權限與代理點餐
↓
Migration
↓
Production Debugging
另外還有 Android 自動簽到工具、Screenshot Action,以及把多個 Repo 共用的 Agent 規則抽出來的 agent-platform。
專案變多之後,Codex 開始做的事情也完全不同。
它不再只是:
幫我寫一個 function。
而可能是一口氣:
甚至一個任務可能跨好幾個 Session 才完成。
這時候,事情開始變得有趣。
也開始變得危險。
例如,我可能只是要求:
點餐頁多顯示「今天總共有幾個便當」。
理想情況應該很簡單:
找到既有 aggregate query
↓
加一個欄位
↓
前端顯示
↓
補測試
但 Coding Agent 很容易開始思考:
要不要順便整理 projection?
API schema 要不要統一?
要不要再抽一層 abstraction?
既然碰到這裡,要不要一起修其他 endpoint?
每一個建議單獨看,都可能是合理的。
問題在於:
合理,不代表這次應該做。
這是我後來很常遇到的一個現象:
Capability ≠ Authority
AI 有能力做更多事情,
不代表它已經取得授權做更多事情。
這跟傳統 autocomplete 很不一樣。
Autocomplete 多寫幾行,我還看得到。
Agent 如果自己把任務擴大,它可能已經改完十個檔案、跑完 migration,才回來跟我報告。
因為怕 Agent 亂改,我開始加規則。
例如要求它:
一開始很好用。
至少它不會一進來就直接修改。
但過一陣子,又出現另一個問題。
同一個工作已經分析完了。
Plan 也核准了。
Agent 下一輪繼續執行時,卻又:
重新掃 Repository
↓
重新讀治理規則
↓
重新分析 Architecture
↓
重新質疑 Plan
↓
重新提出另一個 Plan
本來是為了降低風險建立的安全流程,
最後自己變成了成本。
於是我又開始思考:
所有任務都需要完整 Preflight 嗎?
已經核准過的 Plan,下一輪還應該重新設計嗎?
Agent 到底什麼時候該重新分析,什麼時候只需要執行?
後來才慢慢長出:
這些東西。
它們不是我一開始設計好的架構。
而是因為真的用 Codex 開發,才被問題逼出來的。
讓我開始認真思考「Agent Governance」的,是資料庫。
我的系統裡同時存在過:
local D1
POC D1
formal D1
legacy D1
如果 Agent 改錯一個 React component,
通常還能:
git diff
git restore
但如果 Agent:
事情就不是「Prompt 再寫清楚一點」能解決了。
因為問題已經不是:
「AI 知不知道我要什麼?」
而是:
「AI 在什麼條件下,有權做什麼?」
於是開始出現另一套規則:
低風險 backend change
+
bounded scope
+
tests pass
+
沒有 migration
+
沒有 remote D1 mutation
        ↓
可以 deploy
但:
Schema migration
Remote data mutation
Auth semantics
Production data repair
        ↓
Human Gate
這時候我才意識到:
Coding Agent 的問題,本質上開始很像權限治理。
Agent 還有另一個很現實的限制。
Context 不會無限成長。
一個大型任務跑久了,很容易變成:
前面做過什麼?
為什麼這樣設計?
哪個方案已經被否決?
哪個 migration 已核准?
下一步是什麼?
如果每個新 Session 都重新從 Repository 推理一次,
不只浪費時間,也可能重新做出不同決策。
所以我後來開始做 Handoff。
重點不是保存整段聊天紀錄。
而是保存:
CURRENT STATE
DECISIONS
EVIDENCE
OPEN QUESTIONS
NEXT ACTION
也就是:
保存專案狀態,而不是保存對話。
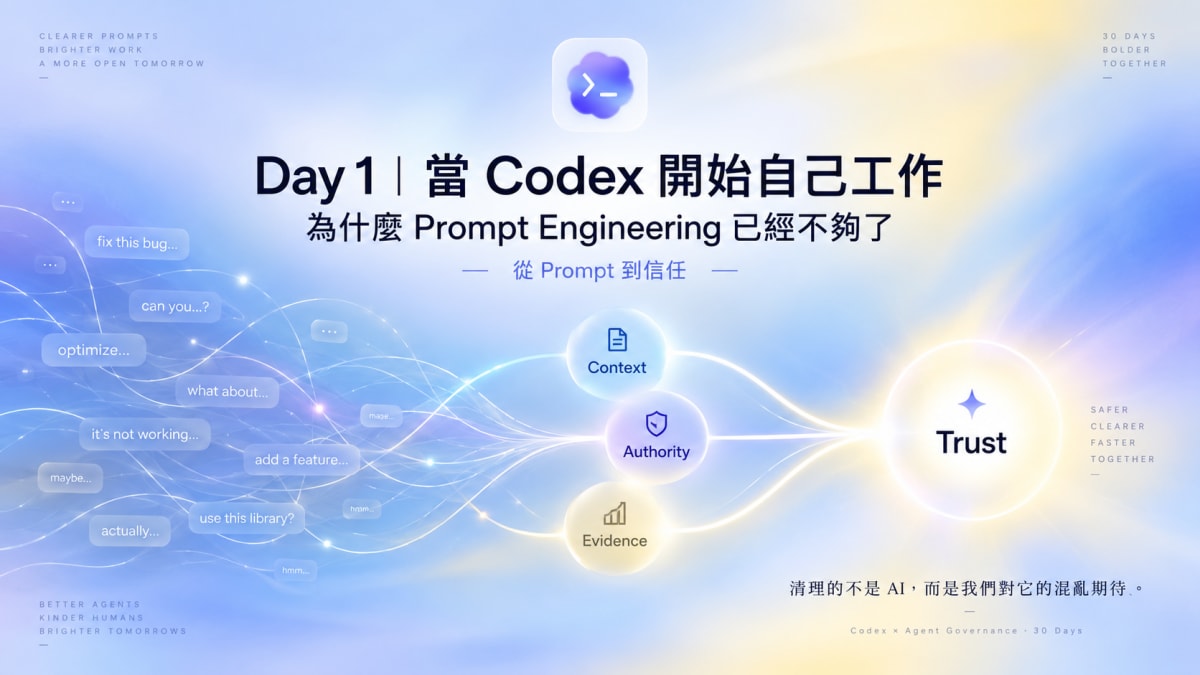
一路踩到這裡之後,我把 Agent 開發遇到的問題濃縮成三個問題。
Agent 現在知道什麼?
它知道:
Agent 可以做什麼?
例如:
讀 Code:可以

改 Code:可以

跑測試:可以

commit:視情況

deploy backend:條件式允許

改 production data:需要 explicit approval
Agent 怎麼證明自己做對了?
不是:
「Implemented successfully。」
而是:
targeted tests: PASS
authorization tests: PASS
lint: PASS
build: PASS
remote smoke: PASS
working tree: expected changes only
也就是:
Context
+
Authority
+
Evidence
這三件事情開始取代單純的 Prompt,變成我使用 Codex 時最關心的核心。
沒有。
Prompt 還是重要。
但我現在會把它放在更大的架構裡看。
Agent Engineering

├─ Product Intent
├─ Agent Governance
├─ Context
├─ Workflow
├─ Skills / Tools
├─ Verification
├─ Evidence
└─ Prompt
Prompt 只是其中一層。
當 AI 只回答一次問題時,
Prompt 幾乎就是全部。
但當 AI 開始:
我需要解決的問題變成:
怎麼讓一個有能力自己工作的 Agent,可以被長期信任?
這就是接下來 30 天,我想實際記錄的主題。
而且我不打算只介紹工具功能。
這個系列會盡量從實際踩過的問題出發:
遇到什麼問題
↓
原本怎麼想
↓
Codex 實際做了什麼
↓
哪裡失敗
↓
留下什麼 Evidence
↓
最後形成什麼規則
包括:
這些規則並不是先設計好,再拿專案來驗證。
剛好相反。
它們都是專案先出問題,規則才慢慢長出來。
下一篇不急著談理論。
先來看看目前實際拿 Codex 開發的幾個 Repository:
它們分別把哪些問題逼了出來?
以及為什麼我最後會開始認為:
Agent 最難治理的地方,不是它不夠聰明,而是它已經聰明到可以做太多事情。
Day 2:
四個真實 Repo,如何把我的 Codex Workflow 一步一步逼成現在這個樣子。


 iThome鐵人賽
 看影片追技術